PostgreSQL LIKE 검색이 느릴 때 pg_trgm Trigram Index로 성능 개선하기

서비스에 검색 기능을 붙이고 나서 한동안은 문제가 없었다. 데이터가 수십만 건을 넘어가면서부터 상황이 달라졌다. 상품명이나 사용자 입력값을 LIKE '%keyword%' 형태로 검색하는 쿼리가 수초씩 걸리기 시작했고, 느린 쿼리 로그에는 해당 쿼리가 반복적으로 기록됐다.
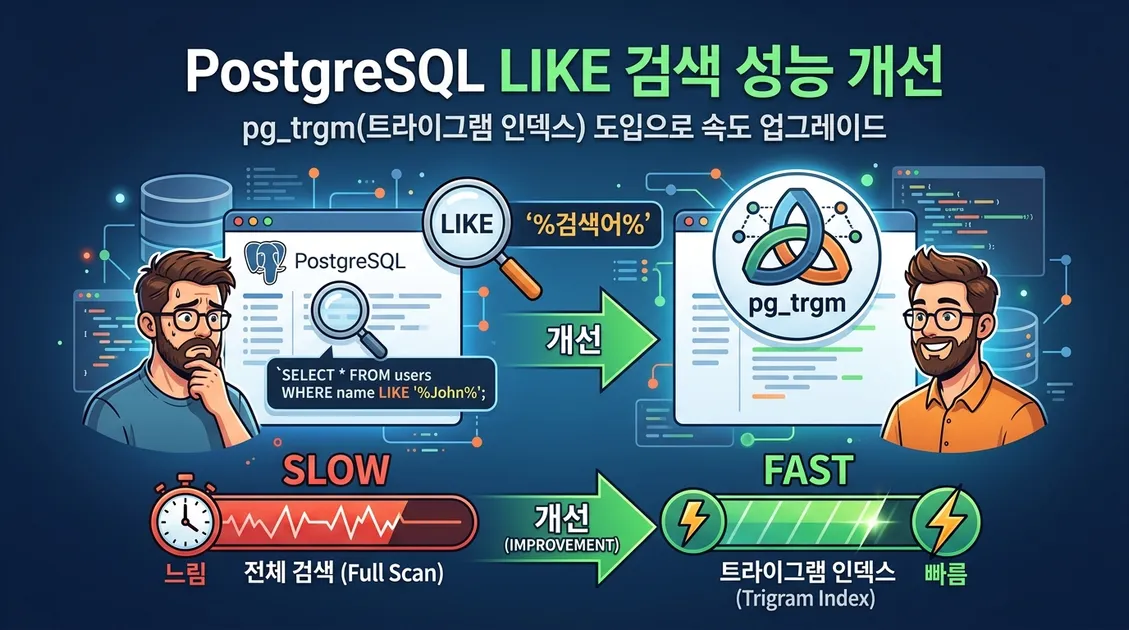
원인은 명확했다. LIKE '%keyword%'처럼 앞에 와일드카드(%)가 붙는 패턴은 PostgreSQL의 B-Tree 인덱스를 전혀 활용하지 못한다. 결국 테이블 전체를 순차적으로 스캔(Sequential Scan)하게 된다. 이 문제를 해결한 방법이 pg_trgm 확장을 활용한 Trigram Index다.
LIKE 검색과 B-Tree 인덱스의 한계
PostgreSQL에서 일반적인 B-Tree 인덱스는 접두사 검색, 즉 LIKE 'keyword%'처럼 뒤에만 와일드카드가 붙는 경우에는 인덱스를 탈 수 있다. 반면 LIKE '%keyword%'나 LIKE '%keyword'처럼 앞에 와일드카드가 붙으면 인덱스를 활용할 수 없다.
이유는 B-Tree 인덱스의 구조 때문이다. B-Tree는 정렬된 순서를 기반으로 탐색 범위를 좁혀가는 방식인데, 문자열 앞부분이 무엇인지 모르는 상태에서는 탐색 시작점을 특정할 수 없다. 그래서 결국 모든 행을 읽어야 한다.
EXPLAIN ANALYZE로 쿼리 실행 계획을 확인하면 이 상황이 바로 보인다.
EXPLAIN ANALYZE
SELECT * FROM products WHERE name LIKE '%노트북%';
출력에서 Seq Scan on products가 나타나고 실행 시간이 길다면, 인덱스가 전혀 사용되지 않고 있다는 뜻이다.
pg_trgm이란 무엇인가
pg_trgm은 PostgreSQL에 기본으로 포함된 확장 모듈이다. Trigram(트라이그램)은 문자열을 연속된 3글자 단위로 잘라낸 토큰들의 집합이다. 예를 들어 노트북이라는 단어는 노트북을 포함해 앞뒤에 공백을 추가한 형태로 처리된 뒤 3글자씩 분리된다.
Trigram Index는 이 토큰들을 인덱스로 저장해두고, 검색 패턴도 동일하게 Trigram으로 분해한 뒤 겹치는 토큰이 있는 행만 빠르게 찾아낸다. 덕분에 앞뒤로 와일드카드가 붙은 LIKE '%keyword%' 패턴도 인덱스를 활용할 수 있게 된다.
GIN(Generalized Inverted Index)과 GiST(Generalized Search Tree) 두 가지 인덱스 타입을 지원하는데, 일반적인 검색 쿼리에서는 GIN이 빠른 조회 성능을 보여주고, GiST는 인덱스 크기가 작고 갱신 비용이 낮다는 차이가 있다. 읽기 쿼리가 많고 검색 성능이 중요하다면 GIN이 대부분 적합하다.
설치 및 인덱스 생성 방법
확장 모듈 활성화
pg_trgm은 PostgreSQL에 이미 포함되어 있으므로 별도 패키지 설치 없이 아래 명령으로 활성화할 수 있다. 슈퍼유저 권한이 필요하다.
CREATE EXTENSION IF NOT EXISTS pg_trgm;
활성화 여부는 다음으로 확인할 수 있다.
SELECT * FROM pg_extension WHERE extname = 'pg_trgm';
GIN Trigram 인덱스 생성
CREATE INDEX idx_products_name_trgm
ON products
USING GIN (name gin_trgm_ops);
gin_trgm_ops는 Trigram 방식으로 GIN 인덱스를 구성하도록 지정하는 연산자 클래스다. 이 부분을 빠뜨리면 일반 GIN 인덱스가 생성되어 LIKE 검색에 활용되지 않는다.
GiST로 생성하려면 다음과 같이 사용한다.
CREATE INDEX idx_products_name_trgm_gist
ON products
USING GIST (name gist_trgm_ops);
인덱스가 실제로 사용되는지 확인
인덱스를 만든 뒤 동일한 쿼리에 대해 EXPLAIN ANALYZE를 다시 실행해보면 실행 계획이 바뀐 것을 확인할 수 있다.
EXPLAIN ANALYZE
SELECT * FROM products WHERE name LIKE '%노트북%';
이번에는 Bitmap Index Scan 또는 Index Scan using idx_products_name_trgm이 나타나야 한다. Seq Scan이 여전히 뜬다면 통계 정보가 오래됐거나, 검색어가 너무 짧아서 인덱스 활용 조건을 충족하지 못한 경우다.
실제 적용 후 변화
실제로 약 80만 건의 상품 데이터가 담긴 테이블에 Trigram GIN 인덱스를 적용한 뒤 성능 차이를 측정했다. 인덱스 적용 전에는 LIKE '%검색어%' 쿼리가 평균 3~4초가 걸렸다. 인덱스 적용 후에는 동일한 쿼리가 수십 밀리초 수준으로 떨어졌다.
인덱스 크기는 컬럼 데이터 크기와 문자열 다양성에 따라 다르지만, 해당 케이스에서는 원본 데이터 크기 대비 GIN 인덱스가 약 2~3배 정도 공간을 차지했다. 스토리지 비용과 검색 성능 사이의 트레이드오프는 미리 파악해두는 편이 좋다.
대용량 테이블에 인덱스를 처음 생성할 때는 시간이 걸리고 테이블에 잠금이 걸릴 수 있다. 운영 중인 서비스라면 CREATE INDEX CONCURRENTLY 옵션을 사용해 잠금 없이 인덱스를 생성하는 방법을 권장한다.
CREATE INDEX CONCURRENTLY idx_products_name_trgm
ON products
USING GIN (name gin_trgm_ops);
유사도 검색(SIMILARITY)도 함께 활용하기
pg_trgm을 활성화하면 LIKE 검색 성능 개선 외에도 유사도 함수를 활용할 수 있다. similarity() 함수는 두 문자열 사이의 Trigram 유사도를 0과 1 사이 값으로 반환한다.
SELECT name, similarity(name, '노트북') AS sim
FROM products
WHERE similarity(name, '노트북') > 0.3
ORDER BY sim DESC;
이 방식은 오타가 섞인 검색어나 표기 변형에도 어느 정도 대응할 수 있어 사용자 경험을 높이는 데 도움이 된다. %(퍼센트) 연산자와 <->(거리 연산자)를 함께 활용하면 GIN 또는 GiST 인덱스를 유사도 검색에도 활용할 수 있다.
SELECT name
FROM products
WHERE name % '노트북'
ORDER BY name <-> '노트북';
% 연산자는 기본 임계값(기본값 0.3)을 기준으로 유사한 문자열을 필터링하고, <-> 연산자는 유사도 거리를 기준으로 정렬한다. 임계값은 pg_trgm.similarity_threshold 파라미터로 세션 또는 서버 수준에서 조정할 수 있다.
주의해야 할 상황
짧은 검색어에서의 한계
Trigram은 최소 3글자를 기준으로 동작한다. 1~2글자짜리 검색어는 유효한 Trigram을 충분히 만들어내지 못하기 때문에 인덱스를 활용하지 못하고 Sequential Scan으로 처리될 수 있다. 짧은 검색어가 자주 발생하는 서비스라면 별도의 처리 로직이 필요하다.
한국어 처리 특성
한국어는 영어와 달리 한 글자가 초성·중성·종성으로 구성되어 있어 Trigram 분해 방식이 영어에 비해 다소 거칠게 동작한다. 완전히 동일한 단어나 명확한 부분 문자열 검색에는 효과적이지만, 형태소 분석 기반의 검색과 비교하면 언어적 유연성은 떨어진다. 정교한 한국어 전문 검색이 필요하다면 pg_trgm만으로는 부족하고, Elasticsearch나 별도의 전문 검색 시스템을 함께 고려해야 한다.
인덱스 유지 비용
GIN 인덱스는 데이터 삽입·수정·삭제 시 인덱스 갱신 비용이 발생한다. 쓰기 작업이 매우 빈번한 테이블이라면 GiST를 선택하거나, gin_pending_list_limit 파라미터를 조정해 GIN의 지연 갱신 특성을 이용하는 방법도 있다.
ilike와의 호환성
대소문자를 구분하지 않는 검색이 필요할 때 PostgreSQL에서는 ILIKE를 사용한다. pg_trgm의 GIN 인덱스는 ILIKE에도 동일하게 적용된다. 별도의 설정 없이 ILIKE '%keyword%' 쿼리도 Trigram Index를 활용할 수 있다.
SELECT * FROM products WHERE name ILIKE '%notebook%';
이 점에서 pg_trgm은 실용적인 측면에서 꽤 편리하다. 대소문자 처리를 위해 lower() 함수로 별도 인덱스를 만들 필요가 없다.
언제 pg_trgm이 적합한가
- 수십만 건 이상의 테이블에서
LIKE '%keyword%'형태의 검색이 빈번하게 발생할 때 - 추가적인 검색 인프라 없이 PostgreSQL 내에서 검색 성능을 개선해야 할 때
- 오타 허용 검색이나 유사도 기반 정렬 기능이 필요할 때
- 애플리케이션 코드 변경 없이 쿼리 성능을 올려야 할 때
반대로 형태소 분석, 동의어 처리, 복잡한 언어적 검색이 핵심인 서비스라면 PostgreSQL의 Full Text Search(tsvector, tsquery)나 별도 검색 엔진을 검토하는 게 맞다. pg_trgm은 그 사이 어딘가에 있는 실용적인 선택지다.
쿼리 성능 문제를 만났을 때 바로 외부 검색 시스템으로 넘어가기보다, pg_trgm처럼 PostgreSQL 자체에서 제공하는 도구를 먼저 살펴보는 것이 운영 복잡도를 낮추는 현실적인 접근 방식이다.