Redis 캐싱 적용 중 Cache Stampede 현상이 발생했을 때 대처하는 방법

Redis를 캐시 레이어로 도입하고 나면 처음에는 응답 속도가 눈에 띄게 빨라진다. 그러다 특정 시점에 갑자기 DB 부하가 치솟고 서비스가 느려지는 일이 생긴다. 로그를 뒤져보면 Redis 캐시 히트율이 순간적으로 바닥을 치고, DB에 동일한 쿼리가 수백 건씩 몰려든 흔적이 남아 있다. 이게 바로 Cache Stampede다.
Cache Stampede란 무엇인가
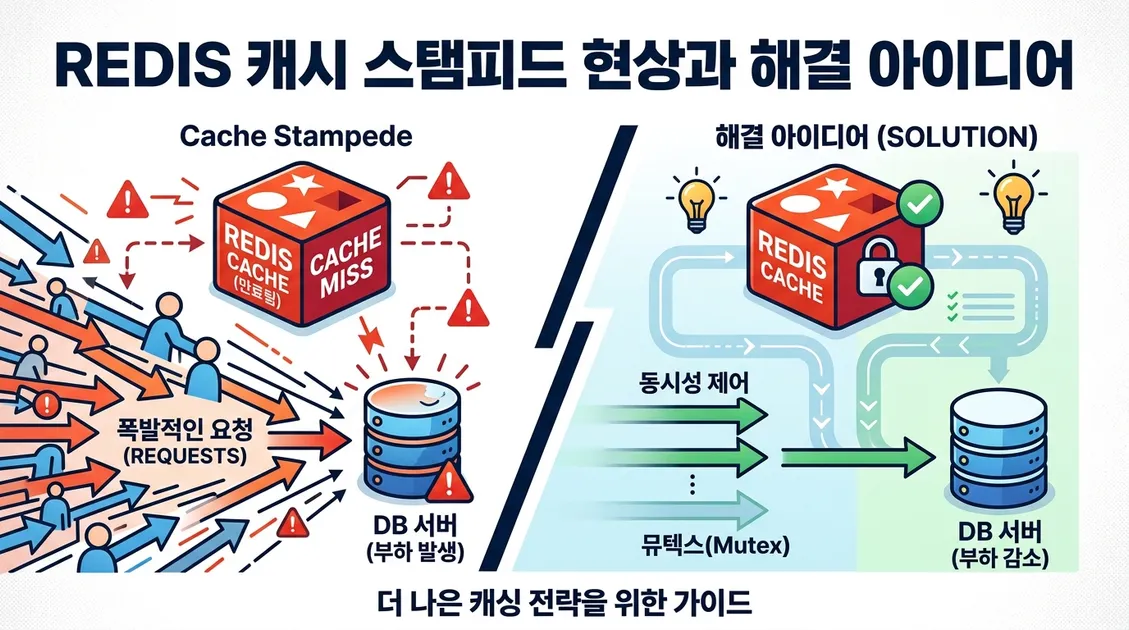
Cache Stampede는 캐시에 저장된 데이터의 TTL(Time To Live)이 만료되는 순간, 해당 데이터를 필요로 하는 다수의 요청이 동시에 캐시 미스를 경험하면서 모두 백엔드 데이터베이스로 쏟아지는 현상이다. ‘Thundering Herd Problem’이라고도 부른다.
예를 들어 상품 상세 페이지 데이터를 Redis에 60초 TTL로 저장해 두었다고 하자. 평소에는 Redis가 요청을 모두 처리하지만, 60초가 지나 캐시가 만료되는 순간 그 페이지에 동시 접속 중인 수백 명의 사용자가 일제히 DB 조회를 시도한다. DB는 짧은 시간 안에 동일한 쿼리를 수백 번 처리해야 하고, 이 부하가 다른 기능에도 연쇄적으로 영향을 준다.
트래픽이 적을 때는 잘 드러나지 않는다. 동시 사용자가 많은 서비스, 특히 이벤트나 특정 시간대에 트래픽이 몰리는 서비스에서 이 문제가 두드러지게 나타난다.
왜 Redis 환경에서 자주 발생하는가
Redis 자체의 문제가 아니라 캐시를 사용하는 패턴의 문제다. 가장 흔한 구현 방식인 ‘Cache-Aside’ 패턴을 생각해보자.
- 요청이 들어오면 Redis에서 데이터를 조회한다.
- 데이터가 있으면 그대로 반환한다.
- 없으면 DB에서 조회한 뒤 Redis에 저장하고 반환한다.
이 패턴은 단순하고 효과적이지만, 3번 단계에서 여러 요청이 동시에 진입할 경우 보호 장치가 없다. 각 요청이 독립적으로 DB 조회를 실행하기 때문에 캐시가 비어 있는 짧은 순간 동안 모든 요청이 DB를 직접 때리게 된다.
TTL이 고정되어 있는 것도 한 가지 이유다. 여러 서버에서 같은 시각에 같은 키의 캐시를 세팅했다면, 동일한 시각에 모든 캐시가 동시에 만료된다. 이 경우 스탬피드 발생 가능성이 더욱 높아진다.
실무에서 사용하는 해결 방법
뮤텍스 락(Mutex Lock) 적용
가장 직관적인 방법이다. 캐시 미스가 발생했을 때, 단 하나의 요청만 DB에 접근해서 데이터를 가져오고 캐시를 갱신하도록 락을 걸어두는 방식이다. 나머지 요청은 락이 해제될 때까지 짧게 대기하거나, 이전 캐시 데이터를 재사용한다.
Redis의 SET NX(SET if Not eXists) 명령어를 활용하면 분산 락을 구현할 수 있다.
SET lock:product:123 1 NX EX 5
이 명령어는 lock:product:123 키가 없을 때만 값을 세팅하고, 5초 후 자동 만료되도록 설정한다. 락 획득에 성공한 요청만 DB를 조회하고, 실패한 요청은 잠시 대기 후 다시 캐시를 확인하는 식으로 흐름을 제어한다.
주의할 점은 락 대기 시간 동안 사용자 응답이 지연될 수 있다는 것이다. 이를 완화하려면 락 대기 중인 요청이 만료 직전의 오래된 캐시 데이터(stale data)를 임시로 반환하도록 설계하는 것이 좋다.
Stale-While-Revalidate 패턴
캐시가 만료된 후에도 오래된 데이터를 잠시 더 반환하면서, 백그라운드에서 비동기로 새 데이터를 가져와 캐시를 갱신하는 방식이다. 사용자 입장에서는 응답 지연 없이 데이터를 받을 수 있고, DB 부하도 단 한 번의 갱신 요청으로 처리된다.
구현 방식은 두 가지 TTL을 두는 것이다. 하나는 ‘소프트 TTL’로 이 시간이 지나면 백그라운드 갱신을 트리거하되 캐시는 계속 서빙한다. 다른 하나는 ‘하드 TTL’로 이 시간이 지나면 캐시를 완전히 무효화한다.
데이터 정합성이 엄격하게 요구되지 않는 콘텐츠, 예를 들어 인기 상품 목록이나 통계 데이터 같은 경우에 잘 맞는 방식이다. 반면 재고 수량이나 결제 정보처럼 실시간 정확성이 중요한 데이터에는 적합하지 않다.
Probabilistic Early Expiration (PER)
확률적 조기 만료라고도 한다. XFetch 알고리즘으로 알려진 이 방법은 캐시가 완전히 만료되기 전에 일부 요청이 미리 캐시를 갱신하도록 유도하는 방식이다.
동작 원리는 이렇다. 캐시 히트가 발생할 때마다 남은 TTL과 데이터를 가져오는 데 걸린 시간을 기반으로 갱신 여부를 확률적으로 결정한다. TTL이 얼마 남지 않을수록 갱신 확률이 높아진다. 결과적으로 캐시가 실제로 만료되기 전에 미리 새 데이터로 교체되기 때문에 스탬피드가 발생할 여지가 줄어든다.
구현이 다소 복잡하지만, 락 대기 없이 자연스럽게 갱신이 이루어진다는 장점이 있다. 특히 DB 조회 시간이 길거나 트래픽이 고르게 분산된 환경에서 효과가 좋다.
TTL 랜덤화(Jitter 추가)
구현이 가장 단순하면서도 효과적인 방법 중 하나다. 캐시를 저장할 때 TTL에 약간의 랜덤 값을 더해서 동시 만료를 방지한다.
import random
base_ttl = 60  # 기본 TTL (초)
jitter = random.randint(0, 10)  # 0~10초 랜덤 추가
final_ttl = base_ttl + jitter
redis.setex(key, final_ttl, value)
여러 서버에서 동시에 같은 캐시를 세팅하더라도 만료 시각이 분산되기 때문에 특정 시점에 모든 캐시가 한꺼번에 만료되는 상황을 피할 수 있다. 복잡한 로직 없이 기존 코드에 한 줄만 추가하면 되므로 빠르게 적용할 수 있다.
단, Jitter만으로는 완전한 해결책이 되지 않는다. 특히 트래픽이 극단적으로 몰리는 상황에서는 랜덤화된 TTL 범위 안에서도 여전히 스탬피드가 발생할 수 있다.
캐시 워밍(Cache Warming)
캐시가 만료되기 전에 선제적으로 새 데이터를 미리 채워두는 방식이다. 크론잡이나 별도의 배치 프로세스가 주기적으로 캐시를 갱신하도록 설계한다. 이렇게 하면 사용자 요청이 캐시 미스를 경험하는 상황 자체가 거의 발생하지 않는다.
트래픽 패턴이 예측 가능한 서비스, 예를 들어 특정 시간대에 이벤트가 열리는 커머스 사이트 등에서 효과적이다. 이벤트 시작 직전에 관련 데이터 캐시를 미리 워밍해두면 오픈 직후 몰리는 트래픽을 Redis가 안정적으로 처리할 수 있다.
다만 캐시 워밍은 운영 복잡도가 올라간다. 어떤 키를 언제 워밍할지 관리해야 하고, 워밍 대상이 많아지면 배치 작업 자체가 부하 요인이 될 수 있다.
상황에 따른 방법 선택
어떤 방법이 가장 좋은지는 서비스의 특성에 따라 달라진다. 아래 표는 각 방법의 특성을 간단히 정리한 것이다.
| 방법 | 구현 난이도 | 응답 지연 가능성 | 데이터 정합성 |
|---|---|---|---|
| 뮤텍스 락 | 중간 | 있음 (대기 시간) | 높음 |
| Stale-While-Revalidate | 중간 | 거의 없음 | 낮음 (일시적으로 오래된 데이터 허용) |
| Probabilistic Early Expiration | 높음 | 없음 | 높음 |
| TTL Jitter | 낮음 | 없음 | 높음 |
| 캐시 워밍 | 높음 | 없음 | 높음 |
실시간 정확성이 중요한 데이터라면 뮤텍스 락과 TTL Jitter를 조합하는 것이 현실적이다. 콘텐츠 중심의 서비스라면 Stale-While-Revalidate가 사용자 경험을 해치지 않으면서 DB 부하를 줄이는 데 효과적이다. 트래픽이 몰리는 이벤트성 서비스라면 캐시 워밍을 사전에 적용해두는 것이 가장 안전하다.
모니터링으로 조기에 감지하기
해결 방법을 적용하는 것만큼 중요한 것이 스탬피드 발생을 조기에 감지하는 것이다. Redis의 캐시 히트율과 DB 연결 수를 함께 모니터링하면 이상 징후를 빠르게 포착할 수 있다.
Redis INFO 명령어로 keyspace_hits와 keyspace_misses 값을 주기적으로 수집하면 히트율 변화를 추적할 수 있다. 히트율이 갑자기 떨어지는 시점과 DB 슬로우 쿼리 로그가 겹친다면 스탬피드를 의심해볼 수 있다.
Prometheus와 Grafana를 연동한 환경이라면 redis_keyspace_hits_total과 redis_keyspace_misses_total 메트릭을 대시보드에 추가해두면 실시간으로 상황을 파악할 수 있다.
마치며
Cache Stampede는 캐시 도입 초기에는 잘 보이지 않다가 트래픽이 늘어나는 시점에 갑자기 터지는 경우가 많다. 한 번 발생하면 DB 부하 → 응답 지연 → 타임아웃 → 재시도 폭증이라는 연쇄 장애로 이어질 수 있어서, 서비스 규모가 커지기 전에 미리 대비하는 것이 훨씬 낫다.
단일 해결책에 의존하기보다는 TTL Jitter처럼 부담 없이 적용할 수 있는 방법부터 시작하고, 서비스 특성에 맞게 뮤텍스 락이나 PER 같은 방법을 조합하는 것이 실용적인 접근이다. 캐시 설계는 처음부터 스탬피드 가능성을 염두에 두는 것이 장기적으로 안정적인 시스템을 만드는 데 도움이 된다.