트랜잭션(Transaction)의 개념과 ACID 원칙 완전 정리

데이터베이스를 다루다 보면 트랜잭션이라는 단어를 자주 접하게 된다. 은행 이체, 주문 처리, 재고 차감처럼 여러 작업이 한 묶음으로 처리되어야 하는 상황에서 트랜잭션은 데이터의 안전성을 지키는 핵심 장치다. 이 글에서는 트랜잭션의 개념부터 ACID 원칙 각각의 의미, 실제 현장에서의 적용 방식까지 구체적으로 다룬다.
트랜잭션이란 무엇인가
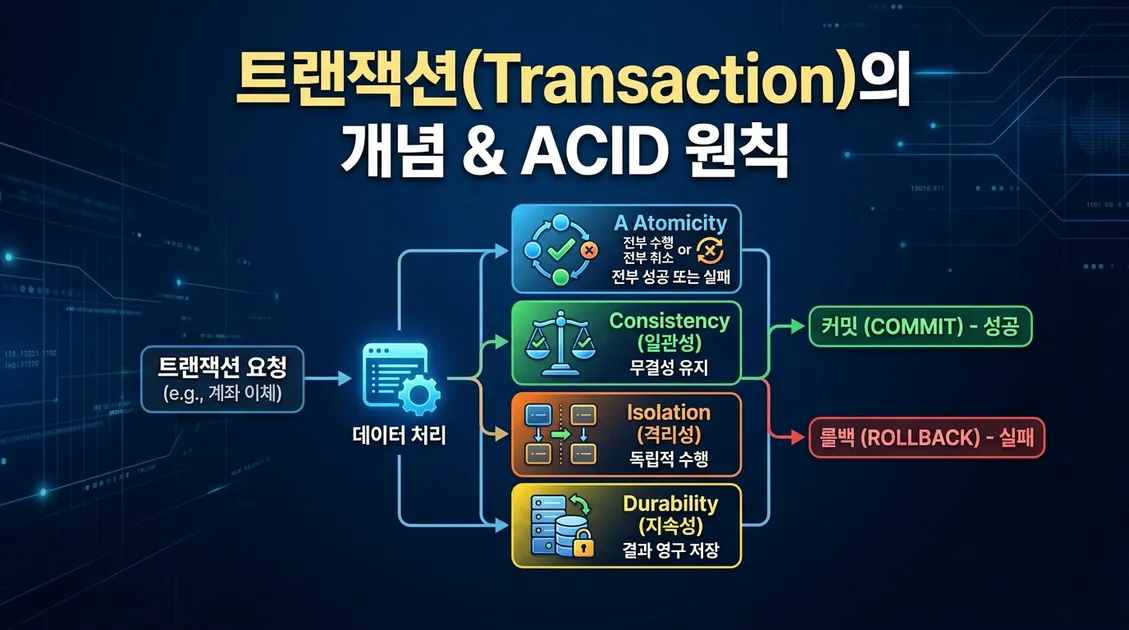
트랜잭션(Transaction)은 데이터베이스에서 하나의 논리적 작업 단위를 의미한다. 여러 개의 SQL 구문이 하나의 작업처럼 묶여 실행되며, 모든 구문이 성공해야 최종적으로 반영되고, 하나라도 실패하면 전체가 취소된다.
가장 이해하기 쉬운 예시는 계좌 이체다. A 계좌에서 100만 원을 빼고, B 계좌에 100만 원을 더하는 두 가지 작업이 있다. 만약 A 계좌에서 출금은 됐는데 B 계좌 입금 도중 오류가 발생하면 돈이 사라지는 문제가 생긴다. 트랜잭션은 이 두 작업을 하나로 묶어 둘 다 성공하거나 둘 다 실패하도록 보장한다.
트랜잭션의 기본 명령어
관계형 데이터베이스에서 트랜잭션을 제어할 때 주로 사용하는 명령어는 다음 세 가지다.
- BEGIN (또는 START TRANSACTION): 트랜잭션 시작을 선언한다.
- COMMIT: 트랜잭션 내의 모든 작업을 데이터베이스에 영구적으로 반영한다.
- ROLLBACK: 트랜잭션 내의 모든 작업을 취소하고 시작 이전 상태로 되돌린다.
BEGIN;
UPDATE accounts SET balance = balance - 1000000 WHERE id = 'A';
UPDATE accounts SET balance = balance + 1000000 WHERE id = 'B';
COMMIT;
위 코드에서 두 번째 UPDATE가 실패하면 ROLLBACK을 실행해 첫 번째 UPDATE도 없었던 일로 되돌릴 수 있다.
ACID 원칙이란
ACID는 트랜잭션이 안전하게 수행되기 위해 반드시 갖춰야 할 네 가지 속성의 앞글자를 딴 용어다. 각각 원자성(Atomicity), 일관성(Consistency), 격리성(Isolation), 지속성(Durability)을 의미하며, 데이터베이스 시스템이 신뢰성을 유지하는 근본 기반이 된다.
원자성(Atomicity)
원자성은 트랜잭션 내의 모든 작업이 전부 실행되거나 전혀 실행되지 않아야 한다는 원칙이다. 중간 상태는 존재하지 않는다. 앞서 언급한 계좌 이체 예시가 원자성을 가장 잘 보여준다.
원자성을 구현하기 위해 데이터베이스는 언두 로그(Undo Log)를 활용한다. 트랜잭션이 수행되는 동안 변경 이전의 데이터를 로그에 기록해두고, 문제가 발생하면 이 로그를 역순으로 적용해 원래 상태로 복원한다.
원자성이 보장되지 않으면 일부 작업만 반영된 불완전한 데이터가 데이터베이스에 남게 되어 데이터 정합성이 무너진다.
일관성(Consistency)
일관성은 트랜잭션이 완료된 후에도 데이터베이스가 항상 정의된 규칙과 제약 조건을 만족하는 유효한 상태여야 한다는 원칙이다.
예를 들어 계좌 잔액이 음수가 될 수 없다는 제약 조건이 있다고 가정하자. 잔액이 50만 원인 계좌에서 100만 원을 이체하려 하면 트랜잭션은 이 제약 조건을 위반하므로 실패해야 한다. 트랜잭션이 성공적으로 완료되면 데이터베이스는 이전과 마찬가지로 모든 규칙을 만족하는 상태를 유지해야 한다.
일관성은 데이터베이스 자체의 제약 조건(PRIMARY KEY, FOREIGN KEY, CHECK 제약 등)과 애플리케이션 레벨의 비즈니스 로직이 함께 책임진다.
격리성(Isolation)
격리성은 동시에 실행되는 여러 트랜잭션이 서로의 중간 상태를 볼 수 없어야 한다는 원칙이다. 각 트랜잭션은 마치 혼자 실행되는 것처럼 동작해야 한다.
격리성이 완벽하게 보장되지 않으면 아래와 같은 이상 현상이 발생할 수 있다.
격리성 부족으로 발생하는 주요 이상 현상
- 더티 리드(Dirty Read): 아직 커밋되지 않은 다른 트랜잭션의 변경 데이터를 읽는 현상. 해당 트랜잭션이 롤백되면 읽은 데이터가 존재하지 않는 것이 된다.
- 논리프리터블 리드(Non-Repeatable Read): 같은 트랜잭션 안에서 동일한 데이터를 두 번 읽었을 때 값이 다른 현상. 다른 트랜잭션이 그 사이에 데이터를 수정하고 커밋했을 때 발생한다.
- 팬텀 리드(Phantom Read): 같은 조건으로 두 번 조회했을 때 결과 집합의 행 수가 달라지는 현상. 다른 트랜잭션이 사이에 행을 삽입하거나 삭제했을 때 발생한다.
트랜잭션 격리 수준(Isolation Level)
SQL 표준은 격리성과 성능 사이의 균형을 위해 네 단계의 격리 수준을 정의하고 있다.
| 격리 수준 | 더티 리드 | 논리프리터블 리드 | 팬텀 리드 |
|---|---|---|---|
| READ UNCOMMITTED | 발생 | 발생 | 발생 |
| READ COMMITTED | 방지 | 발생 | 발생 |
| REPEATABLE READ | 방지 | 방지 | 발생 |
| SERIALIZABLE | 방지 | 방지 | 방지 |
격리 수준이 높아질수록 데이터 정확성은 높아지지만 동시성 처리 성능은 낮아진다. MySQL InnoDB의 기본값은 REPEATABLE READ이며, PostgreSQL의 기본값은 READ COMMITTED다.
격리성을 구현하는 주요 기술로는 잠금(Locking)과 MVCC(Multi-Version Concurrency Control)가 있다. MVCC는 데이터의 여러 버전을 유지해 읽기 작업이 쓰기 작업을 방해하지 않도록 하는 방식으로, 대부분의 현대 데이터베이스가 채택하고 있다.
지속성(Durability)
지속성은 커밋된 트랜잭션의 결과는 시스템 장애가 발생하더라도 영구적으로 보존되어야 한다는 원칙이다. 서버가 다운되거나 정전이 발생해도 이미 커밋된 데이터는 사라지지 않아야 한다.
지속성을 보장하기 위해 데이터베이스는 WAL(Write-Ahead Logging) 방식을 사용한다. 실제 데이터 파일에 변경 내용을 쓰기 전에 먼저 로그 파일에 해당 변경 작업을 기록하는 방식이다. 시스템이 갑자기 종료되더라도 재시작 시 로그를 분석해 완료된 트랜잭션은 다시 적용(Redo)하고, 미완료 트랜잭션은 취소(Undo)해 데이터베이스를 일관된 상태로 복원한다.
ACID vs BASE: 분산 시스템에서의 선택
ACID는 관계형 데이터베이스(RDBMS)에서 강력한 데이터 무결성을 보장하는 모델이다. 반면 대규모 분산 시스템이나 NoSQL 데이터베이스에서는 가용성과 성능을 위해 ACID 대신 BASE 모델을 채택하는 경우가 많다.
BASE는 다음 세 가지 개념의 약자다.
- BA (Basically Available): 항상 응답을 제공하되, 일부 데이터가 일시적으로 불일치할 수 있다.
- S (Soft State): 시스템 상태가 외부 입력 없이도 시간이 지나면서 변할 수 있다.
- E (Eventually Consistent): 결국에는 일관성이 보장된다는 최종 일관성 모델이다.
MongoDB, Cassandra, DynamoDB 같은 NoSQL 데이터베이스가 BASE 모델을 따르는 대표적인 사례다. 어떤 모델을 선택할지는 서비스의 요구사항에 따라 달라진다. 금융 거래처럼 정확성이 절대적으로 중요한 경우에는 ACID가 필수이고, 소셜 미디어 피드나 로그 수집처럼 약간의 불일치를 허용할 수 있는 경우에는 BASE가 더 적합할 수 있다.
실무에서 트랜잭션을 다룰 때 주의할 점
트랜잭션의 개념을 이해했더라도 실제 코드에 적용할 때는 몇 가지를 유의해야 한다.
트랜잭션 범위는 최소화해야 한다. 트랜잭션이 길어질수록 잠금 보유 시간이 늘어나 다른 트랜잭션의 대기 시간이 길어지고 데드락(Deadlock) 발생 가능성도 높아진다. 트랜잭션 내에서 외부 API 호출이나 파일 I/O처럼 시간이 오래 걸리는 작업은 가능하면 트랜잭션 바깥으로 빼는 것이 좋다.
데드락에 대한 처리 로직을 갖춰야 한다. 두 트랜잭션이 서로 상대방이 보유한 잠금을 기다리며 영원히 진행되지 못하는 상태를 데드락이라 한다. 데이터베이스는 데드락을 감지하면 한쪽 트랜잭션을 강제로 롤백시키는데, 애플리케이션에서는 이 경우를 감지하고 재시도하는 로직을 구현해두어야 한다.
자동 커밋(Auto Commit) 설정을 파악해야 한다. 많은 데이터베이스 클라이언트는 기본적으로 자동 커밋 모드로 동작한다. 이 경우 SQL 구문 하나하나가 독립적인 트랜잭션으로 처리된다. 여러 작업을 하나의 트랜잭션으로 묶으려면 명시적으로 트랜잭션을 시작해야 한다.
애플리케이션 레벨 트랜잭션도 고려해야 한다. Spring 프레임워크의 @Transactional 어노테이션처럼 애플리케이션 레벨에서 트랜잭션을 선언적으로 관리하는 방식도 있다. 이 경우 트랜잭션 전파(Propagation) 설정을 제대로 이해하지 못하면 의도치 않게 트랜잭션이 분리되거나 합쳐지는 문제가 생길 수 있다.
트랜잭션의 저장점(Savepoint)
트랜잭션 전체를 롤백하지 않고 특정 시점까지만 롤백하고 싶을 때는 저장점(Savepoint)을 활용할 수 있다.
BEGIN;
UPDATE orders SET status = 'processing' WHERE id = 1;
SAVEPOINT after_order_update;
UPDATE inventory SET stock = stock - 1 WHERE product_id = 100;
-- 재고 차감 실패 시 주문 상태 업데이트는 유지하고 재고 차감만 취소
ROLLBACK TO SAVEPOINT after_order_update;
COMMIT;
Savepoint는 복잡한 트랜잭션 로직을 처리할 때 유연성을 제공하지만, 과도하게 사용하면 코드가 복잡해지고 의도를 파악하기 어려워지므로 필요한 경우에 한정해서 사용하는 편이 좋다.
트랜잭션과 ACID 원칙은 데이터베이스를 올바르게 사용하기 위한 기초 중의 기초다. 단순히 용어를 암기하는 것에서 그치지 않고, 각 원칙이 실제로 어떤 문제를 방지하며 어떤 기술로 구현되는지를 이해하면 더 안정적이고 예측 가능한 시스템을 설계할 수 있다.