OpenAI·Claude API 토큰 비용 줄이기: 프롬프트 최적화와 캐싱 적용 실전 가이드

API 비용 청구서를 처음 받아보는 순간은 꽤 충격적이다. 프로토타입을 만들 때는 크게 신경 쓰지 않았는데, 실제 트래픽이 붙기 시작하면 토큰 비용이 생각보다 빠르게 쌓인다. 특히 OpenAI의 GPT-4o나 Anthropic의 Claude 3.5 Sonnet처럼 성능 좋은 모델일수록 입력·출력 토큰당 단가가 높기 때문에, 아무 생각 없이 API를 호출하다 보면 월말에 예상치 못한 지출이 발생한다.
이 글은 실제 서비스에 LLM API를 붙이면서 겪은 시행착오와 그 과정에서 정착한 비용 절감 방법을 담은 실전 기록이다.
토큰 비용 구조부터 파악해야 한다
OpenAI와 Anthropic 모두 입력 토큰(Input tokens)과 출력 토큰(Output tokens)을 따로 계산한다. 일반적으로 출력 토큰이 입력 토큰보다 비싸다. 예를 들어 GPT-4o 기준으로 입력 토큰은 1M당 $5, 출력 토큰은 1M당 $15 수준이다(2025년 기준, 변동 가능).
Claude의 경우도 비슷한 구조인데, Claude 3.5 Sonnet은 입력 1M당 $3, 출력 1M당 $15다. 모델 선택만으로도 비용 차이가 크게 나기 때문에, 태스크별로 어떤 모델이 적합한지 먼저 판단하는 것이 중요하다.
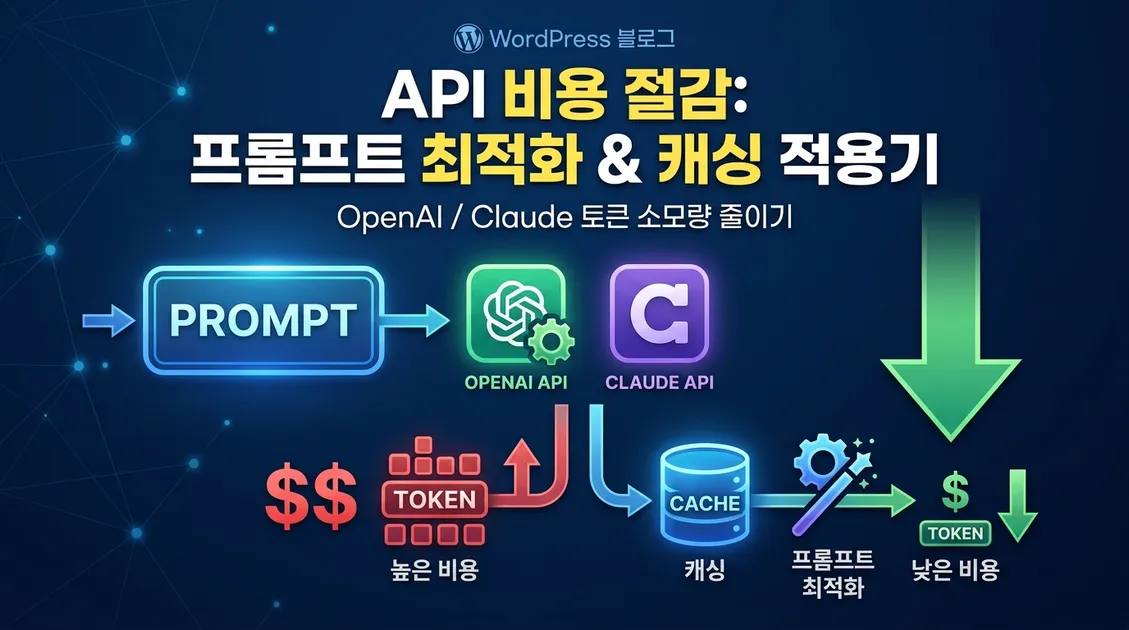
비용 절감 전략은 크게 세 가지 방향으로 나뉜다.
- 입력 토큰 줄이기: 프롬프트 자체를 짧고 효율적으로 만드는 것
- 출력 토큰 줄이기: 모델이 불필요하게 긴 답변을 생성하지 않도록 유도하는 것
- API 호출 횟수 줄이기: 캐싱을 통해 동일한 요청을 반복하지 않는 것
프롬프트 최적화: 불필요한 토큰을 걷어내는 작업
시스템 프롬프트의 군살 빼기
시스템 프롬프트는 매 요청마다 입력 토큰에 포함된다. 초기에 작성한 시스템 프롬프트를 그대로 쓰다 보면 어느 순간 수백 단어가 넘어가 있는 경우가 많다. 특히 예시를 여러 개 넣거나, 같은 말을 다른 표현으로 반복하거나, 불필요한 설명을 추가하는 경우가 흔하다.
실제로 운영 중인 서비스에서 시스템 프롬프트를 리팩토링했을 때 평균 30~40% 정도 토큰 수를 줄인 경험이 있다. 핵심은 모델이 이미 알고 있는 내용은 굳이 명시하지 않는 것이다. “당신은 도움이 되는 AI 어시스턴트입니다”처럼 의미 없는 문장, 지나치게 긴 역할 설명, 중복된 제약 조건은 모두 제거 대상이다.
Few-shot 예시 최소화
Few-shot 예시는 모델의 출력 품질을 높이는 데 효과적이지만, 토큰을 많이 소모한다. 예시가 길수록, 개수가 많을수록 비용이 올라간다.
몇 가지 대안을 시도해봤다.
- 예시를 3개에서 1개로 줄이고 대신 출력 형식을 더 명확하게 기술하는 방식
- JSON 스키마나 구조화된 출력 형식으로 예시를 대체하는 방식
- OpenAI의 경우
response_format으로 JSON 모드를 활성화해 별도 파싱 예시 없이도 구조화된 출력을 유도하는 방식
예시를 완전히 제거했을 때 품질이 떨어진다면, 가장 대표적인 예시 하나만 남기되 가능한 한 짧게 압축하는 것이 좋다.
출력 길이 제어
출력 토큰은 입력보다 단가가 높기 때문에, 모델이 필요 이상으로 길게 답변하지 않도록 유도하는 것이 중요하다.
max_tokens 파라미터로 상한을 설정하는 것은 기본이고, 프롬프트 안에서도 출력 형식을 명확히 지정하는 것이 효과적이다. 예를 들어 “3문장 이내로 요약해줘” 또는 “JSON 형식으로만 응답해줘”처럼 구체적인 지시를 포함하면 불필요한 전문(preamble)이나 설명 없이 핵심만 출력된다.
모델이 “물론입니다, 제가 요약해드리겠습니다” 같은 인사말을 붙이지 않도록 하는 것도 출력 토큰 절약에 도움이 된다. “인사말이나 설명 없이 바로 결과만 출력해”라는 지시 한 줄이 꽤 효과적이다.
컨텍스트 창 관리
멀티턴 대화 구조에서는 이전 대화 내역 전체를 매번 context에 넣으면 토큰이 기하급수적으로 늘어난다. 실제로 긴 대화 세션에서는 이전 메시지를 압축하거나 요약해서 context에 포함시키는 전략을 써야 한다.
구체적인 방법은 다음과 같다.
- 일정 턴 이상 지난 메시지는 잘라내고, 대신 이전 대화 요약문을 시스템 프롬프트 말미에 추가
- 중요한 사실이나 결정 사항만 별도로 추출해서 요약 형태로 유지
- 슬라이딩 윈도우 방식으로 최근 N턴만 유지
캐싱 전략: 같은 요청을 두 번 하지 않기
Prompt Caching 기능 활용
AnthropicClaude API는 Prompt Caching 기능을 공식 지원한다. 시스템 프롬프트처럼 반복적으로 사용되는 긴 텍스트에 cache_control 파라미터를 붙이면, 해당 텍스트가 서버 측에 캐싱되어 이후 요청에서 입력 토큰 비용이 대폭 절감된다. 캐시 히트 시 입력 토큰 비용이 약 90% 줄어드는 효과가 있다.
messages = [
    {
        "role": "user",
        "content": [
            {
                "type": "text",
                "text": long_system_context,
                "cache_control": {"type": "ephemeral"}
            },
            {
                "type": "text",
                "text": user_query
            }
        ]
    }
]
캐시는 기본적으로 5분간 유지되며, 자주 변하지 않는 긴 컨텍스트(문서, 매뉴얼, 코드베이스 등)에 적용할 때 효과가 크다.
OpenAI도 일부 모델에서 Prompt Caching을 지원하기 시작했다. 프롬프트의 앞부분이 동일한 경우 자동으로 캐시 히트가 발생하며, 별도 설정 없이도 적용된다. 단, 프롬프트의 앞부분이 요청마다 달라지면 캐시 효과가 없으므로, 고정된 내용은 반드시 앞쪽에, 동적인 내용은 뒤쪽에 배치해야 한다.
애플리케이션 레벨 캐싱
API 레벨의 캐싱 외에도 애플리케이션에서 직접 응답을 캐싱하는 방법이 있다. 동일하거나 매우 유사한 입력에 대해 이전에 받은 응답을 재사용하는 방식이다.
구현 방식은 단순하다. 요청 파라미터(프롬프트, 모델, 온도 등)를 기반으로 해시값을 생성하고, 그 해시를 키로 Redis나 인메모리 캐시에 응답을 저장한다. 동일한 해시의 요청이 들어오면 API를 호출하지 않고 캐시에서 응답을 반환한다.
import hashlib
import json

def get_cache_key(model, messages, temperature):
    payload = json.dumps({
        "model": model,
        "messages": messages,
        "temperature": temperature
    }, sort_keys=True)
    return hashlib.sha256(payload.encode()).hexdigest()
이 방법은 FAQ 응답, 정형화된 분류 작업, 반복되는 문서 요약 등에 특히 효과적이다. 실시간성이 중요하지 않은 작업이라면 캐시 TTL을 길게 설정하는 것도 방법이다.
의미론적 캐싱(Semantic Caching)
단순 해시 기반 캐싱은 입력이 완전히 동일할 때만 동작한다. 하지만 실제 사용자 쿼리는 같은 의미지만 다른 표현으로 들어오는 경우가 많다. 이를 해결하는 것이 의미론적 캐싱이다.
동작 원리는 다음과 같다. 입력 텍스트를 임베딩 모델로 벡터화한 뒤, 벡터 DB(Pinecone, pgvector, Weaviate 등)에서 유사도 검색을 수행한다. 유사도 임계값 이상의 기존 응답이 있으면 그것을 반환하고, 없으면 API를 호출한 뒤 결과를 저장한다.
임베딩 API 비용과 벡터 검색 레이턴시가 추가되지만, LLM API 호출 비용이 훨씬 크기 때문에 트래픽이 일정 수준 이상이면 경제적으로 유리하다.
모델 선택과 라우팅 전략
모든 요청에 최고 성능 모델을 쓸 필요는 없다. 간단한 분류, 키워드 추출, 단순 요약 등은 GPT-4o Mini나 Claude Haiku처럼 저렴한 모델로도 충분한 품질이 나온다.
실용적인 접근법은 태스크 복잡도를 기준으로 모델을 라우팅하는 것이다.
| 태스크 유형 | 추천 모델 | 이유 |
|---|---|---|
| 단순 분류, 키워드 추출 | GPT-4o Mini, Claude Haiku | 빠르고 저렴하며 충분한 품질 |
| 일반 요약, 번역, 기본 Q&A | GPT-4o, Claude Sonnet | 균형 잡힌 성능과 비용 |
| 복잡한 추론, 코드 생성, 전문 분석 | GPT-4o, Claude Opus | 높은 정확도가 필요한 경우 |
라우팅 로직은 규칙 기반으로 구현하거나, 경량 분류기를 따로 만들어 적용할 수 있다. 입력 길이, 키워드, 요청 유형 등을 기준으로 모델을 선택하면 된다.
실제 적용 후 비용 변화
실제로 한 내부 프로젝트에서 위 방법들을 순차적으로 적용한 결과를 간단히 정리하면 다음과 같다.
- 시스템 프롬프트 리팩토링으로 평균 입력 토큰 약 35% 감소
- 출력 길이 제어 지시 추가로 출력 토큰 약 20% 감소
- Claude Prompt Caching 적용으로 캐시 히트 시 입력 비용 약 85% 절감
- 애플리케이션 캐싱 도입으로 반복 요청 약 40%가 캐시에서 처리
- 모델 라우팅으로 전체 API 호출 중 약 60%를 저렴한 모델로 전환
개별 기법의 효과는 서비스 특성마다 다르지만, 이 기법들을 함께 적용하면 기존 대비 비용을 절반 이하로 줄이는 것은 충분히 가능하다.
비용 모니터링 체계 갖추기
최적화를 적용했다면 그 효과를 추적하는 체계도 함께 갖춰야 한다. OpenAI와 Anthropic 모두 API 응답 헤더나 응답 본문에 사용한 토큰 수를 제공하므로, 이를 로깅해서 대시보드로 시각화하면 이상 징후를 빠르게 파악할 수 있다.
최소한 다음 지표는 모니터링하는 것이 좋다.
- 요청별 입력·출력 토큰 수
- 모델별 API 호출 횟수와 비용
- 캐시 히트율
- 평균 응답 토큰 수 추이
Datadog, Grafana, 또는 간단히 Google Sheets와 연동된 로그 시스템으로도 충분히 구현할 수 있다. 비용 이상이 발생하면 알림을 받도록 설정해두는 것도 필수다.
LLM API 비용 관리는 한 번에 완성되는 작업이 아니다. 서비스가 성장하면서 사용 패턴이 바뀌고, 모델 가격도 변하며, 새로운 최적화 기법도 계속 나온다. 중요한 것은 처음부터 비용을 측정하는 습관을 들이고, 데이터를 바탕으로 점진적으로 개선해 나가는 것이다.